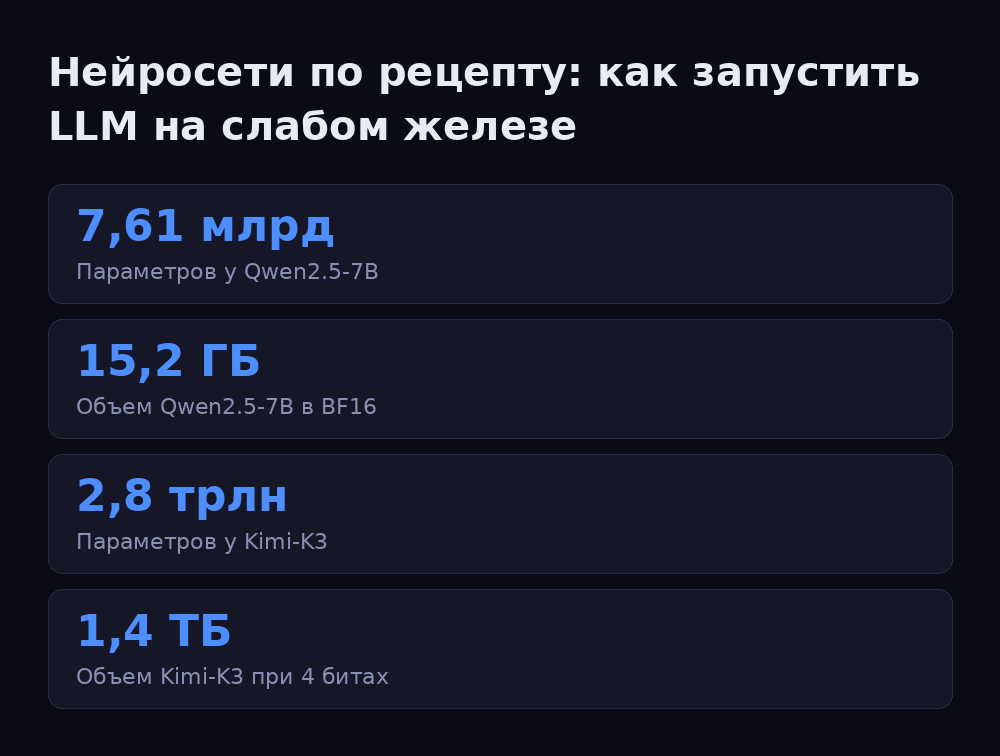
Современные искусственные интеллекты растут быстрыми темпами. Открытая модель Qwen2.5-7B-Instruct с её 7,61 миллиарда параметров в формате BF16 весит порядка 15,2 ГБ, а гигантская Kimi-K3 содержит 2,8 триллиона параметров и требует около 1,4 ТБ дискового пространства даже при 4-битной квантовке. Чтобы запустить такую модель, обычно требуются гигабайты редкой видеопамяти и мощные графические ускорители.
Разработчики давно ищут способ уменьшить аппетиты нейросетей. Одно из перспективных направлений — отказ от традиционного хранения гигантских матриц. Вместо огромного массива чисел предложено хранить компактный «рецепт» — математический генератор, который вычисляет нужные веса прямо в процессе работы.
Как работает генерация весов на лету
В классическом подходе каждый вес нейросети — это отдельное число в матрице. Подход «по рецепту» заменяет матрицу компактной функцией. Для любого элемента матрицы его значение рассчитывается по формуле на основе индекса строки, столбца и небольшого набора управляющих параметров.
Роль такого алгоритма-генератора могут выполнять самые разные структуры: от крошечных обучаемых гиперсетей и генераторов псевдослучайных чисел с зафиксированным семенем (seed) до фрактальных функций, кодовых книг и динамических систем. Некоторые исследователи даже экспериментируют с рекурсивными архитектурами, где один и тот же блок модели прогоняется многократно на разной глубине.
Три ключевых бюджета: диск, память и время
Переход на вычисляемые веса меняет правила балансировки ресурсов. Разработчикам приходится учитывать три основных бюджета:
Размер на диске. Объем файла модели кардинально снижается, поскольку вместо миллиардов чисел хранятся лишь параметры генератора, латенты и таблицы масштабирования.
Рабочая память (RAM и VRAM). Веса можно восстанавливать не целиком, а небольшими блоками непосредственно перед умножением на входные данные. После вычисления слоя память сразу освобождается. Однако свою долю памяти продолжают забирать сами активации, генератор и KV-кэш attention.
Цена вычисления. За компактность приходится платить процессорным временем. Генерация весов требует дополнительной математики, и главное мастерство инженеров заключается в том, чтобы спрятать эти расчеты за другими параллельными операциями.
Будущее LLM на слабых устройствах
Подобные методы сжатия и генерации приближают момент, когда большие языковые модели смогут работать на бытовых устройствах и смартфонах без постоянного подключения к облачным серверам. Ознакомиться с разбором оригинального исследования и другими техническими видео можно на YouTube-канале Habr.
Партнёрский материалПока технологии оптимизации развиваются, бизнес и авторы контента могут не ждать прорыва и использовать эффективные языковые модели в платформе NeuroM.A.X. Оценить возможности системы для автоматизации задач и ознакомиться с тарифами NeuroM.A.X. можно на нашем сайте, а за свежими анонсами следите в новостях NeuroM.A.X..